企业官网在GEO中的价值,是提供一个由企业持续维护、能够被访客直接阅读、也能被自动系统访问的事实入口。页面做得漂亮只是基础;更关键的是结构是否清楚、网址是否稳定、正文是否完整、主体与来源是否明确。
用页面回答不同任务
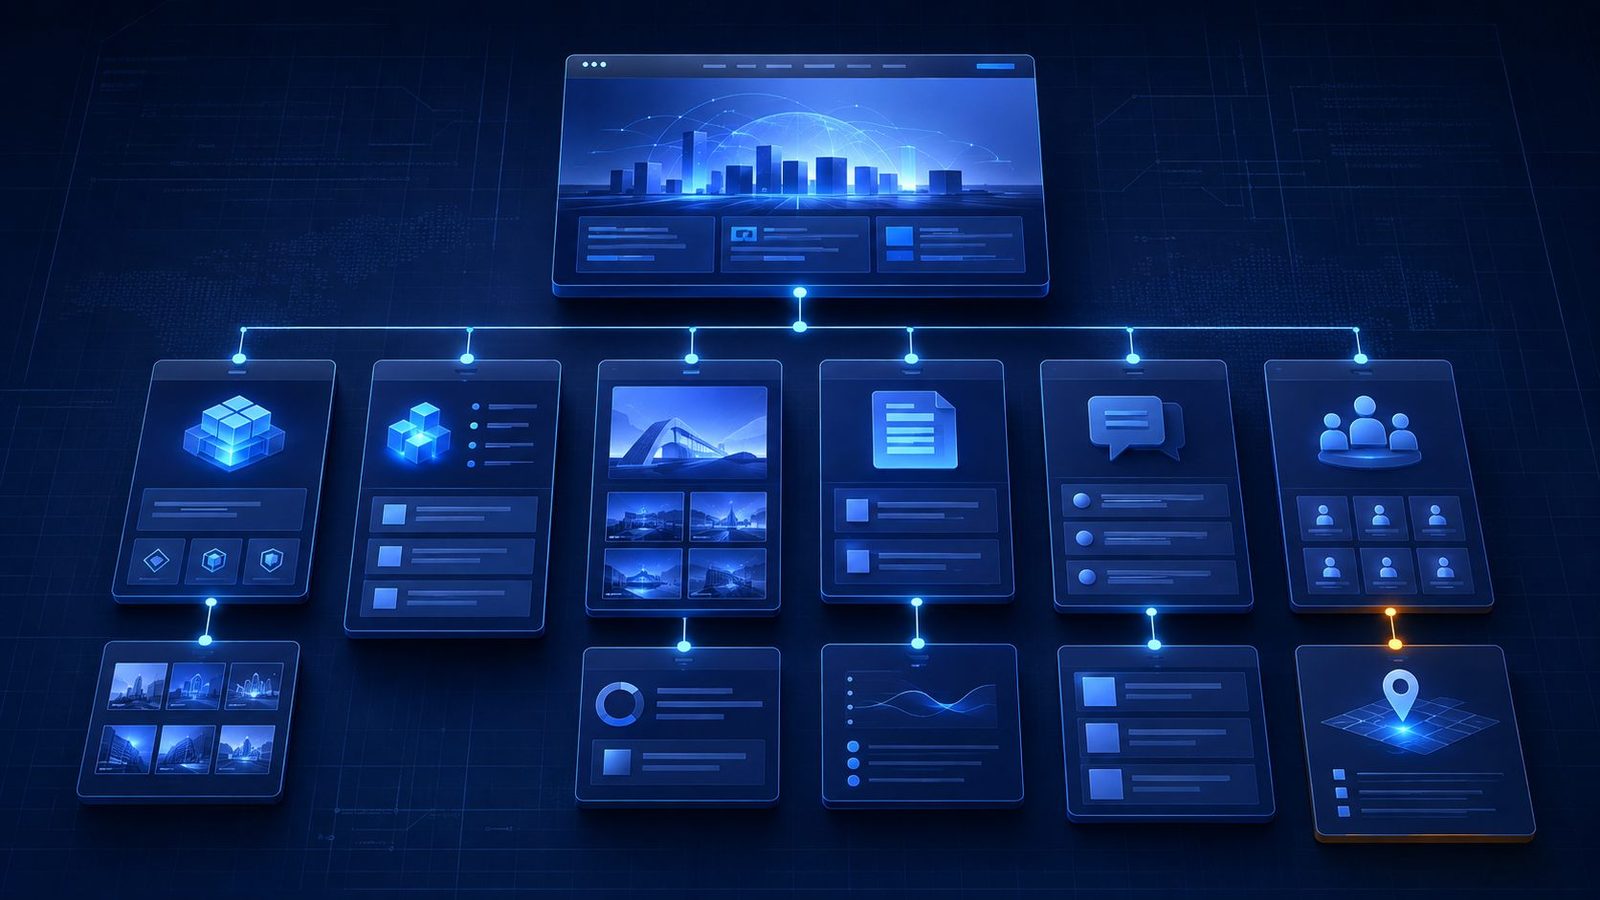
一个实用的企业官网可以分成六类页面:
- 首页:说明企业是谁、核心服务、代表案例与联系入口;
- 服务页:逐项说明适用对象、工作内容、流程、交付和限制;
- 案例页:记录真实背景、实施内容、观察时间、证据和结果边界;
- 知识文章:回答客户在选择与实施中提出的具体问题;
- 关于与资质:核对公司主体、团队、真实荣誉和品牌关系;
- 联系页:提供统一电话、邮箱、地址和咨询方式。
每个重要主题拥有独立网址,既方便客户分享,也便于团队更新和监测。首页负责引导,不需要复制所有正文。
让正文在HTML中可读
核心事实不要只放在轮播图、海报、视频画面或需要点击后才加载的组件里。页面源和渲染结果应包含标题、小标题、段落、列表、图片替代文字和链接。
Google公开说明抓取时会渲染JavaScript,但也列出了脚本页面需要注意的限制。S01 对企业站而言,稳妥做法是让关键正文随页面初始HTML提供,动画用于增强阅读体验,而非承载唯一信息。
建立稳定网址与内部链接
服务、案例和文章都应使用可预测且长期稳定的网址。导航、栏目页和相关文章区要能到达重要内容,避免产生没有入口的孤立页面。
同一内容若存在多个网址,应明确主网址。Google文档把重定向与rel="canonical"视为较强的Canonical信号,Sitemap中的偏好相对较弱。S04 网站内部链接也应始终指向主网址。
Sitemap可以帮助系统发现新页和更新页,却不保证抓取或索引。S02 它应自动反映真实可发布页面,不要包含草稿、错误页和跳转后的旧网址。
正确处理爬虫访问
robots.txt用于管理爬虫可以请求哪些网址,不能代替noindex或访问权限。S03 上线前应检查生产环境有没有遗留整站禁止规则。
不同AI产品可能有不同爬虫和用途。OpenAI公开区分OAI-SearchBot、GPTBot与ChatGPT-User,并提供各自说明。S08 企业应根据是否希望进入相应搜索、是否允许训练用途等实际意图配置,同时定期查看官方文档更新。不能把这一配置泛化为豆包等其他平台的规则。
用结构化数据补充可见事实
首页或关于页面可以使用Organization结构化数据,表达公司名称、品牌别名、官网、Logo、地址和联系点。S05 文章页可以用Article或BlogPosting表达标题、图片、作者、发布时间和更新时间。S06
结构化数据必须和页面正文一致。它帮助系统理解页面,不会弥补空洞内容,也不保证特定富结果、排名或AI引用。
给案例和文章建立可信字段
案例需要区分客户项目、企业自身实践和方法示例。客户名称、Logo、项目过程和效果数字只有在事实与授权都确认后才公开;无法确认的字段宁可暂缺,也不要用其他网站的内容替换名称后发布。
文章应保留作者、发布主体、真实发布日期、更新日期和参考来源。转载到其他平台时可调整摘要和表达,但应保留官网主版本,并在可能的情况下指回原文。多份高度相似的内容要做好主网址和版本管理。
上线前检查清单
- 所有核心页面无需登录即可打开;
- 状态码、标题和正文正常;
- 手机端能阅读,不隐藏关键内容;
- 导航和相关文章链接可到达每个重要页面;
- Canonical、Sitemap和站内链接使用同一主网址;
- 生产环境没有误加
noindex或整站robots阻止; - 公司和品牌信息与标准资料表一致;
- 结构化数据通过工具校验且与可见内容一致;
- 图片有替代文字,案例和资质有授权记录;
- 监测表保存上线日期、网址和后续检查结果。
官网不是一次性交付的展示册,而是企业知识不断更新的主入口。页面结构、内容与技术配置协同维护,才能让客户和自动系统都更容易找到并理解准确资料。
说明:文中Google与OpenAI资料只解释相应产品的公开机制,不代表其他AI平台采用相同规则。参考资料见页面末尾。
参考资料
- S01|Google Search Central:How Google Search Works
- S02|Google Search Central:Sitemaps overview
- S03|Google Search Central:robots.txt introduction
- S04|Google Search Central:Canonical URL
- S05|Google Search Central:Organization structured data
- S06|Google Search Central:Article structured data
- S08|OpenAI Developers:Overview of OpenAI Crawlers